 Brij Pandey

Google 刚上线一门 1 小时的课程,从零讲智能体工程……
1.3K 赞 · 310K 次浏览
 鹦鹉 AI
你的智能体可以搜索网页、读取任意页面,花费 0 积分。免费调用返回空结果或被拦截时,parrot 会换下一家供应商,所以智能体照样拿得到网页、站点、社交帖子、商店商品与评价,全部经由同一份数据目录接入。开源,无需套餐。
 WebAccess
 付费网页 API
你的智能体提出的是任务,不是某一家供应商。parrot 按命中率、价格和速度依次尝试承接这个任务的供应商,拿到第一个真实结果就停。按成功计费的供应商,没命中就不收费。
 › Stripe 的 Crunchbase 页面TinyFish
 Crawl4AI
 AnyAPI
 Stripe
 › Amazon 上的无线耳机
 JustOneAPI
 SerpAPI
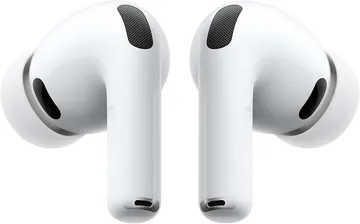 AirPods Pro 3
 › r/LocalLLaMA 的热门帖子
 ScrapeCreators
 TikHub「已经 2 个月了」
 › 一个 YouTube 视频下的评论Crawl4AIScrapeCreatorsTikHub
 「先别玩梗……」
每次路由调用都会说明:谁给了答案、先试了谁、各自花了多少。
// parrot call parrot.web.extract --data '{"url":"crunchbase.com/organization/stripe"}'
"_鹦鹉AI": {
  "served_by": "anyapi.web.scrape",
  "tried": [
    { "provider": "tinyfish", "outcome": "miss",  "charged_micro": 0 },
    { "provider": "crawl4ai", "outcome": "error", "status": 403, "charged_micro": 0 },
    { "provider": "anyapi",   "outcome": "hit",   "charged_micro": 700 }
  ],
  "charged_micro": 700
}
控制项都放在请求头里、不写进请求体,调用本身仍是供应商自己的请求。
X-parrot-Route-Prefer | 优先试某一家,比如免费的 TinyFish。 |
X-parrot-Route-Exclude | 跳过某家给过你坏结果的供应商。 |
X-parrot-Route-Max-Cost | 给单次调用设上限。不设的话,一次没命中最多多走 700 积分 的供应商。 |
X-parrot-Route-Waterfall | 设为 0 时,第一次没命中就停。 |
平台数据返回的是字段,不是一整页 HTML:智能体少烧 token,网站改版也不用跟着修。
TinyFish · 下一家 0 积分AnyAPI · 下一家 Brij PandeyGoogle 刚上线一门 1 小时的课程,从零讲智能体工程……
 Stripe

我们欢迎 Parafin 加入 Stripe。我们将一起为平台拓展更多收入机会……
 r/LocalLLaMA
Qwen 发布了 QwenGyre,一个用来在超长、超复杂任务上训练 AI 智能体的强化学习框架
 以及各平台更多供应商Amazon
 Walmart
 eBay
 JustOneAPI 10.36 积分 · SerpAPI 每个 10.5 积分
 App Store · iOS,美国区
 Google Play · 1B+ 次安装
 Crawl4AI0.11 积分 a pageXLinkedInReddit
 TikTok
 InstagramYouTube
 Threads
 FacebookAmazonWalmarteBay
 Shopify
 EtsyApp StoreGoogle PlayTrustpilot
 Maps