Gemini 3.6 Flash 发布:输出 token 比 3.5 Flash 省17%(DeepSWE 上最高省65%)、单位输出成本更低;Flash-Lite 冲到 350 token/秒;Cyber 版并入 CodeMender 做安全
Introducing Gemini 3.6 Flash, 3.5 Flash-Lite, and 3.5 Flash Cyber
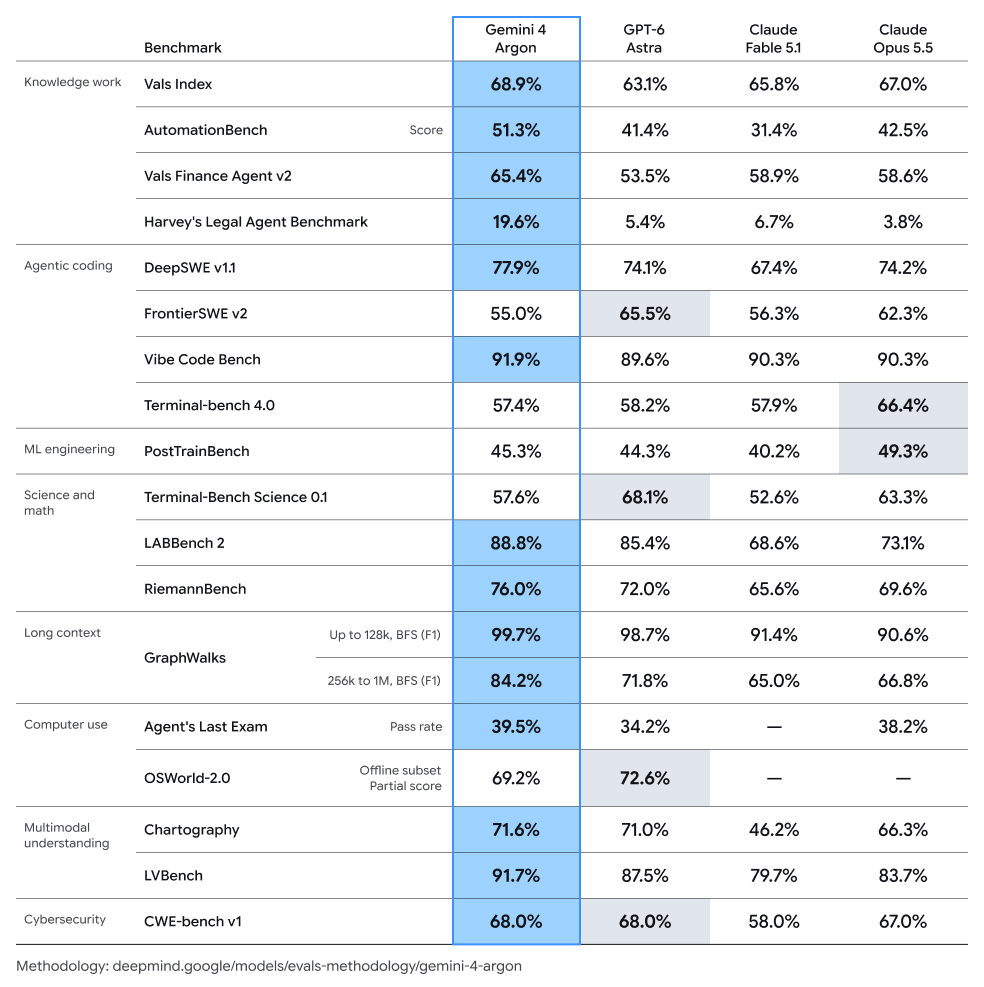
Google DeepMind:生产级 agent 开发要的是更高 token 效率、更低延迟与更稳表现,Flash 系列就是效率×质量的甜点档。本次三款同发——3.6 Flash(主力)编码/知识工作/多模态全面更好:据 Artificial Analysis Index 输出 token 用量比 3.5 Flash 降17%、在 Datacurve 的 DeepSWE 等基准最高降65%,且每输出 token 成本更低;3.5 Flash-Lite 是 3.5 档最快最省,Artificial Analysis 口径 350 输出 token/秒,agent 工作流显著超越历代 Flash-Lite;3.5 Flash Cyber 与代码安全 agent CodeMender 配对,给出接近前沿的性价比安全能力。另透露 Gemini 3.5 Pro 正在合作伙伴处测试。
模型#Google DeepMind
推荐理由:一次发布同时给出效率、速度与安全三条产品线:3.6 Flash 用 17% 的输出 token 降幅和更低单价降低 agent 成本,Flash-Lite 面向高并发低延迟场景,Cyber + CodeMender 则把安全修复做成受控的专用能力。